2026年10月30日、Google・Microsoft・OpenAIの3社は、「サイトの内容をAIの学習に使わないでほしい」と伝える共通の記述に対応する方針を発表した。サイトに設置する「robots.txt」というファイルにこの2行の記述を加えると、AI企業ごとに書き分けなくても、対応する各社にまとめて伝えられる。Anthropicも、10月30日時点でこの記述への対応を始めたとヘルプページに記した。各社の説明では、AIの学習を拒否しても検索結果には影響しないが、AIが質問に答えるときにサイトの内容を使うかどうかの扱いは、会社によって異なる。
robots.txtに書く2行
robots.txtは、サイトを読みに来るプログラム(ボット)に向けて、サイト側が「ここは読まないで」「ここは読んでよい」と書いておくファイルだ。共通の記述は次の2行で、「サイト全体をAIの学習に使わないでほしい」と伝える。
User-Agent: __usage_ai-training
Disallow: /
1行目の「User-Agent」は、どのボットに向けた指示かを書く欄で、ここではボットの名前の代わりに、AIの学習という用途を表す共通の名前を書く。2行目の「Disallow: /」は、サイト全体を対象に拒否するという意味になる。この例はMicrosoftが手引きに載せたもので、Googleもクローラーの一覧で同じ名前を示した。
この記述のもとになったのは、インターネットの多くの技術標準を定める団体IETFに提出された草案で、4社の発表やヘルプページはいずれもこの草案にリンクしている。ただし、これは個人が提出した草案で、IETFの承認を受けた正式な標準ではない。
学習用と検索用は別のボット
AI企業のボットは、用途ごとに名前が異なる。OpenAIでは、学習用がGPTBot、ChatGPTの検索用がOAI-SearchBotで、それぞれ別に設定できる。
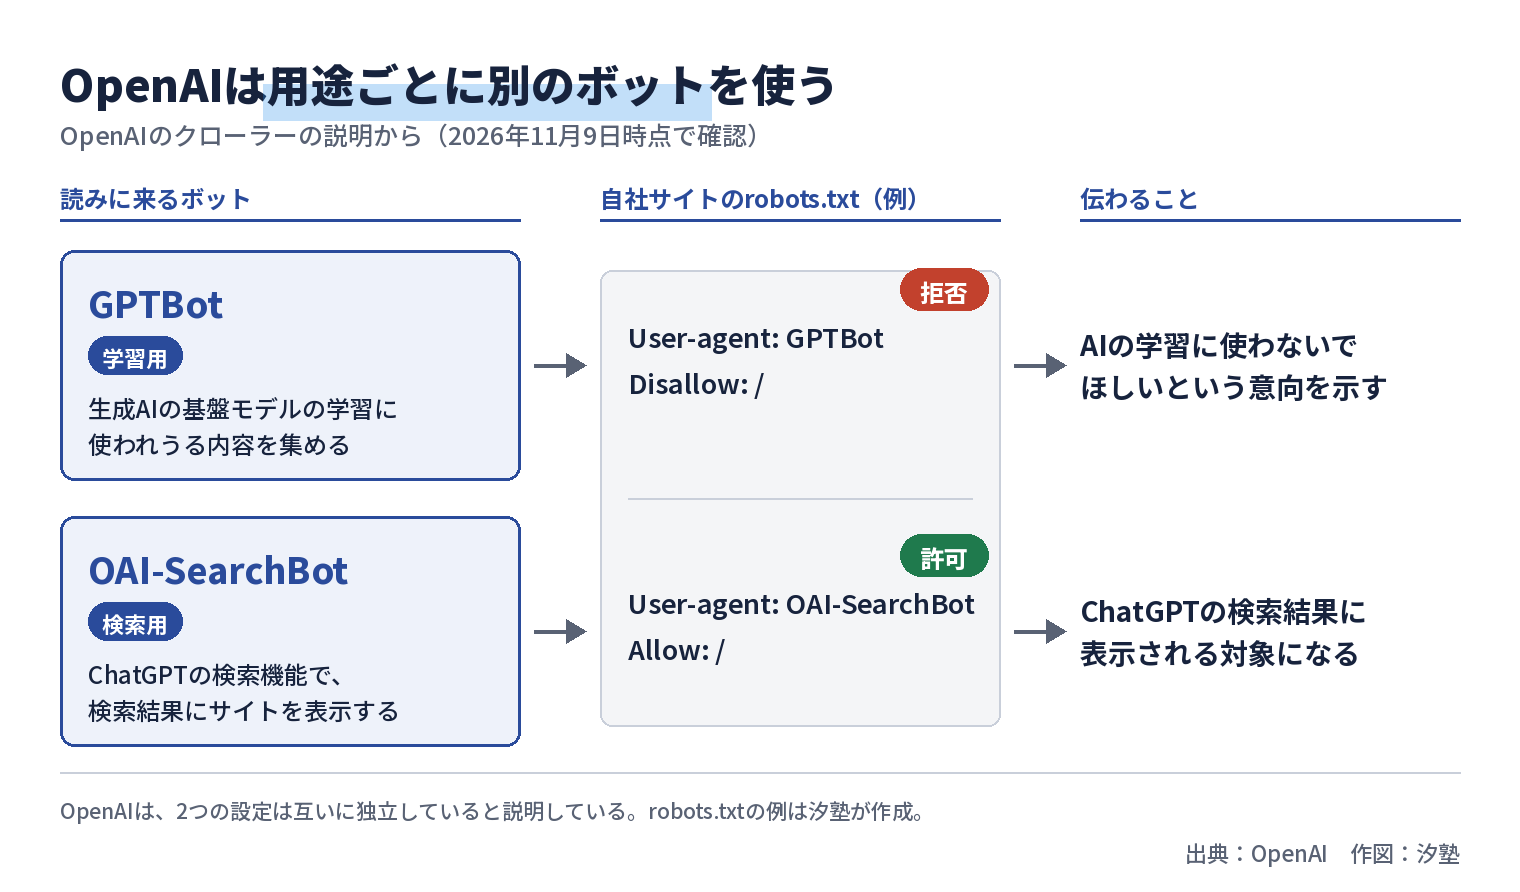
次の例(OpenAIの説明をもとに汐塾が作成)は、GPTBotを拒否して学習に使わないでほしいという意向を示しつつ、ChatGPTの検索結果に表示されるためのOAI-SearchBotは許可する記述だ。
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
「Disallow: /」はサイト全体の読み取りを拒否し、「Allow: /」は許可するという意味になる。
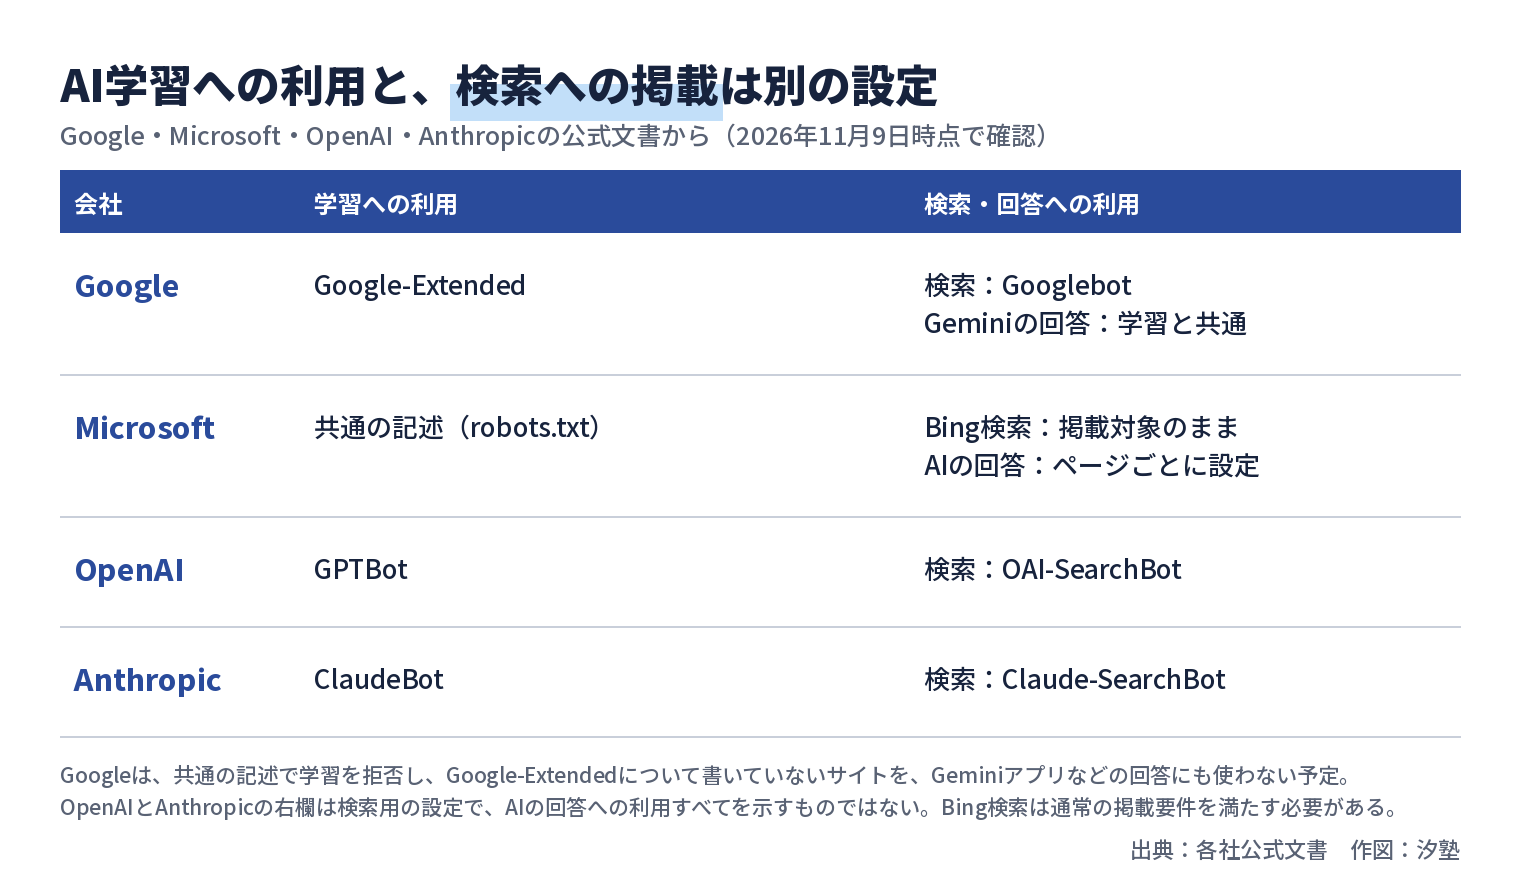
Anthropicも、学習用のClaudeBotと検索用のClaude-SearchBotを分けている。Claude-SearchBotを拒否すると、検索結果にサイトが表示されにくくなる可能性があると説明する。
Microsoftは、AIの学習に使うかどうかと、AIの回答に使うかどうかを、別々に設定する仕組みを示した。回答に使うかどうかは、robots.txtではなく、ページごとに設定する。どちらを拒否しても、通常の掲載要件を満たしていれば、従来のBing検索に載る対象であることは変わらない。
GoogleはGeminiの回答にも同じ設定を使う
Googleは、Geminiへの利用を「Google-Extended」という設定で管理する。Google-Extendedは、サイトを読みに来るボットの名前ではなく、robots.txtで使い道を指定するための名前だ。Geminiの学習に加えて、GeminiアプリなどでAIが答えるときにサイトの内容を使うかどうかにも関わり、Google検索への掲載や順位には影響しない。
共通の記述の2行だけを書き、Google-Extendedについて何も書いていないサイトは、Google-Extendedも拒否したものとして扱う予定だ。そのため、次の2行だけを書いたサイトの内容は、Googleが対応した後、Geminiの学習にも、Geminiアプリなどの回答にも使わない扱いになる。
User-Agent: __usage_ai-training
Disallow: /
Geminiアプリの回答には使ってほしい場合は、Google-Extendedを名指しして許可する。Googleは、Google-Extendedを明示的に許可したサイトは、Geminiアプリの回答に表示される対象になると説明している。ただし、Google-ExtendedはGeminiの学習にも関わるため、許可すると学習への利用も許可することになる。次の例は、Microsoftの手引きにある共通の記述と、Googleのクローラー一覧にあるGoogle-Extendedの記述例をもとに、汐塾が作成した。
User-Agent: __usage_ai-training
Disallow: /

User-agent: Google-Extended
Allow: /
各社がこの記述に従い始める時期は異なる。Googleは2027年(クローラー一覧では2027年初め)、Microsoftは2027年2月1日から、サイトを巡回する際に適用する予定だ。OpenAIは発表から数か月以内の実装を目指し、Anthropicは全サービスへ順次広げている。
広報の視点 ー robots.txtは、多くのサイトで、ドメインのすぐ後ろに「/robots.txt」を付けたアドレス(例:https://www.example.jp/robots.txt)をブラウザで開くと読めます。学習用のGoogle-Extended・GPTBot・ClaudeBotについてどう書いてあるかを、サイトの管理担当者と一緒に確認します。あわせて、検索用のOAI-SearchBotやClaude-SearchBotまで拒否していないかも見ます。確認しておけば、「自社サイトはAIに使われているのか」と社内で聞かれたときに、学習への利用と検索への掲載に分けて答えられます。
出典:Google(AI学習の共通コントロールへの対応を告知したブログ、2026年10月30日) / Microsoft(学習とAIの回答への利用の設定を告知したBingのブログ、2026年10月30日) / OpenAI(AI学習への利用意向の共通シグナルに関する発表、2026年10月30日) / IETF(個人草案「Machine-Readable Training Preference Signal」、2026年10月30日) / Google(共通クローラーの一覧、2026年10月30日更新) / OpenAI(クローラーの概要、2026年11月9日閲覧) / Anthropic(クローラーに関するヘルプ、2026年11月9日閲覧)